指摘が多すぎるとライターから言われたとき、いちばん手早い対処はルールごと切ることです。文体チェックをオフにする、辞書セットを一括で無効にする。指摘の数は確かに減ります。ただし正しい指摘も同じ勢いで消えるので、数週間後には「入れている意味がない」に着地する。
手を打つ前に決めることが1つあります。目の前の1件がどの種類の誤検出かです。種類が違えば効く手も違うのに、ひとくくりのまま扱っている限り、選べるのはルールを切るか我慢するかの二択だけになる。精度の高いツールを探しに行くのは、そのあとでいい。
分け方は3つで足ります。ツールの名前に関係なく成立する分類です。
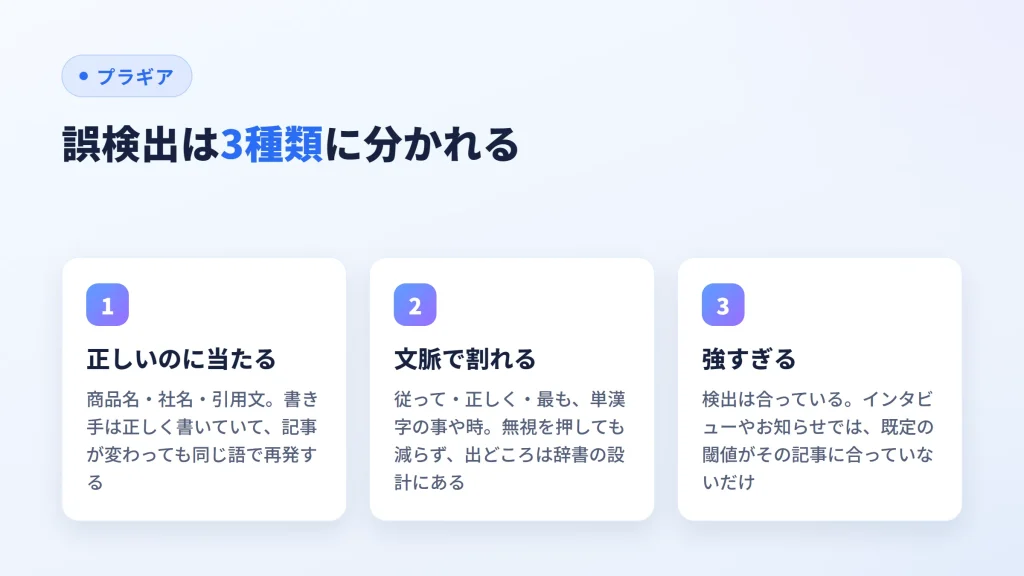
- 正しく書いてあるのに当たる — 商品名・社名・引用文のように、語そのものが例外であるもの
- その文脈でだけ正しい — 品詞や前後の語で判断が割れるもの
- 検出は合っているが、この記事には強すぎる — 閾値と重要度の問題
3つ目は、厳密には誤検出ではありません。それでも「誤検出が多い」として持ち込まれる指摘には、これが混ざります。仕分けないまま辞書を削ると、削らなくていいものから減っていく。
商品名や引用に当たるものは、語の側で外す
いちばん件数が出るのがこの型です。
自社サービス名の綴りが一般的な表記ゆれの誤形を含んでいる、社名の送り仮名が辞書の推奨表記とぶつかる、引用した公的文書の表記が自社ルールと違う。どれも書き手は正しく書いていて、直しようがない。
見分け方は簡単で、記事が変わっても同じ語で再発します。今日の記事で消しても、来週の記事でまた出る。だからこの型は、指摘を消すのではなく語を登録して外すのが正解になります。日本語校正マネージャーなら「許可語」種別の辞書に入れる、除外設定に任せる、一致方法を完全一致に変える。この3つの使い分けは表記ゆれ辞書の作り方に書きました。
ひとつだけ、そこに書かなかった内幕を足しておきます。同梱の許可語辞書は0件、中身の無い空の器です。汎用の許可語というものが作れなかったのが理由の半分で、もう半分は表示の都合でした。辞書が1冊も無い状態だと、エディタの指摘に出る「辞書に登録して以後許可」という操作が出せない。空でも1冊置いておかないと、いちばん使ってほしい逃がし方に誰も気づかないままになります。
文脈で割れる語は、消すより辞書から抜く
従って、正しく、最も。単漢字の 事 や 時。それと ユーザ → ユーザー のような長音を付ける方向の登録。
この型は、無視ボタンをいくら押しても減りません。出どころが辞書の設計そのものだからです。手を入れる先は指摘ではなく辞書のエントリのほうで、そもそも入れてはいけない語の基準は、上と同じ記事に3つ挙げてあります。長音を付ける方向が原理的に登録できない理由も、その基準1です。
ここで効いてくるのが、その辞書をどこから持ってきたかです。
OSSの日本語校正辞書(prh や textlint 系)を一括で取り込むと、この型が一気に増えます。定番項目がまとまって入っているので、そのまま流し込みたくなる。日本語校正マネージャーの同梱辞書がIT20件・一般30件・冗長表現9件・重言14件で止まっているのは、件数を絞りたかったからではなく、1件ずつ上の基準に当てて、引っかかったものを落とした結果がこの数だからです。逆に言えば、件数の多い辞書をそのまま引き継いだチームは、この確認をまだやっていない状態から始めることになります。
見直すときは、全件を上から検分しないほうがいい。誤検出が出た語から抜くほうが早く終わります。使っていない語まで含めて全件を見直す時間は、どの編集部にもありません。実際に指摘として出た語だけが、いま誤検出を生んでいる語です。
消し方は「次も同じものが出るか」で選ぶ
指摘を消す操作にも段階があります。日本語校正マネージャーの無視は5スコープです。
| 消し方 | 効く範囲 | 使える人 |
|---|---|---|
| この指摘のみ | その投稿の同じルール×同じ文字列 | 自分が編集できる投稿なら全員 |
| この投稿のみ | その投稿 | 自分が編集できる投稿なら全員 |
| このライターのみ | そのライターの記事 | 編集者以上 |
| このカテゴリのみ | そのカテゴリの記事 | 編集者以上 |
| このルールを一時停止 | サイト全体 | 編集者以上 |
投稿者・寄稿者が使えるのは上の2つまで。1回の不便を理由にサイト全体のルールを止められると統一の意味が消えるので、下の3つは編集者以上に限っています。
スコープを1段階にしなかった理由も、同じところにあります。ボタンが「無視」1つだけだと、消す=ルールを止めるになる。かといって「この指摘のみ」しか用意しないと、同じ語で毎回同じ操作が発生して、設定には何も残らない。この仕様にしたのは、消す操作そのものに「これは今回だけか、恒久的な例外か」を判断させたかったからです。
判断の目安はひとつ。恒久的な例外は、無視ではなく辞書に落とす。無視で消した指摘は本文からは見えないので、増えるほど「なぜこの記事だけ指摘が出ないのか」が誰にも説明できなくなります。許可語辞書に1行入っていれば、後任がそれを見て判断できる。
強すぎるだけの指摘は、切らずに弱くする
3種類目に行きます。検出そのものは正しいのに、その記事にとっては厳しすぎる指摘です。
日本語校正マネージャーの既定値だと、1文は80文字まで、1文内の読点は4個まで、同じ接続詞の連続は2回で警告、同じ語尾の連続は3文まで。いずれも変更前提の既定値で、この数字の決め方と絶対視しない態度は一文の長さの基準に書きました。標準的な解説記事なら妥当な線ですが、インタビューの書き起こしでは話し言葉がそのまま長文になるし、お知らせ記事は定型文なので語尾が続きます。基準がずれているだけで、指摘は正しい。
ここでルールを無効にすると、必要な記事にも効かなくなります。取れる手は3つ。
- 重要度を下げる(Error / Warning / Info / Suggestion の4段階)
- 閾値そのものを変える(一文の上限を80文字から100文字へ、など)
- 対象を絞る(カテゴリ「インタビュー」だけ長文を切る、ベテランのライターだけ冗長表現を外す)
3つ目が効くケースは想像より多いはずです。「うるさい」と言われてルールを切るのは、全員に対して切ること。カテゴリや書き手の単位に落とせるなら、失うものが少なくて済みます。ルールをどの単位で重ねられるかは7層のルール合成で書きました。
重要度についてもう一段。同梱ルール9本はすべてWarningで、既定プロファイルに公開ブロックは付いていません。誤検出でツールが嫌われる典型は、この初期状態をいきなりErrorへ上げてしまうことです。上げる順番の話はNG表現を止める記事の末尾にあります。
減らす順番
手を打つ順番を間違えると、同じ作業を何度もやることになります。次の順で進めるのが早いはずです。
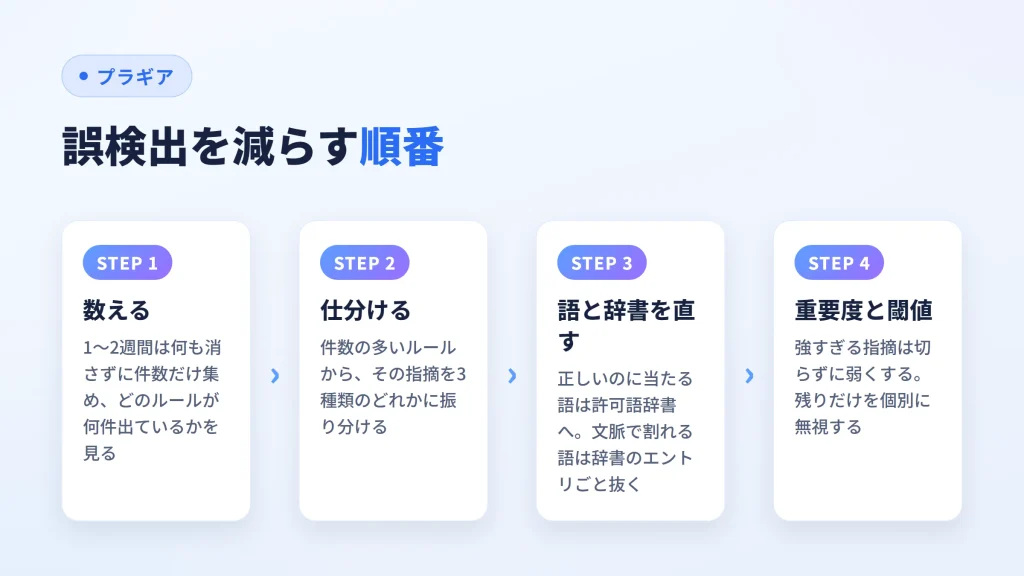
- 1〜2週間、何も消さずに件数だけ集める。どのルールが何件出ているかをルール別に見る
- 件数の多いルールから、その指摘を上の3種類に仕分ける
- 種類1(正しいのに当たる)は、許可語辞書・除外設定・一致方法で語の側から外す
- 種類2(文脈で割れる)は、辞書のエントリごと抜く
- 種類3(強すぎる)は、重要度と閾値を調整する。カテゴリやライターに絞れないかも見る
- どれにも当たらなかった残りだけを、個別に無視する
日本語校正マネージャーだとルール別・ライター別・カテゴリ別の指摘数がダッシュボードに出るので、1と2はそこで済みます。集計機能がないツールでも、1週間ぶんの指摘をスプレッドシートに書き出せば同じことができる。大事なのは消す前に数えるという順番のほうです。
逆にやりがちなのが、6から始めてしまうこと。目の前の指摘を1件ずつ無視していくと、作業は毎記事発生し続けて、設定には何も蓄積されません。何ヶ月経っても誤検出の量が変わらないとすれば、原因はここにあることが多いはずです。
誤検出はゼロにはなりません。形態素解析を使わない照合方式である以上、文脈で割れる語は原理的に残るし、そもそも意味を読んで判断はしない設計です。目指すところはゼロ件ではなく、指摘の一覧を上から見る気になる比率を保つこと。そこまで来れば、残った指摘はちゃんと直されます。
指摘をWordPressの編集フロー全体のどこで受けるかは編集フローに校正を組み込むに、辞書と除外設定の画面や動作環境は日本語校正マネージャーの製品ページにまとめてあります。