一致モードは、全記事スキャンの画面に置かれたサイト全体のダイヤル——ではありません。用語を1件開いた編集フォームの中にあり、しかも「個別記事の検出」と「全体バッチの検出」に1つずつ、計2つ並んでいます。ここを取り違えたまま「厳密にしたのに何も変わらない」と往復するのが、この機能でいちばん時間を食う道です。
名前だけ見れば厳密がいちばん安全に見えるのに、寄せた途端に拾ってほしかった語まで候補から消える。3つのボタンが何を切り替えているのかを先に開いておきます。
モードは設定ではなく、トグルを一括で切り替えるボタン
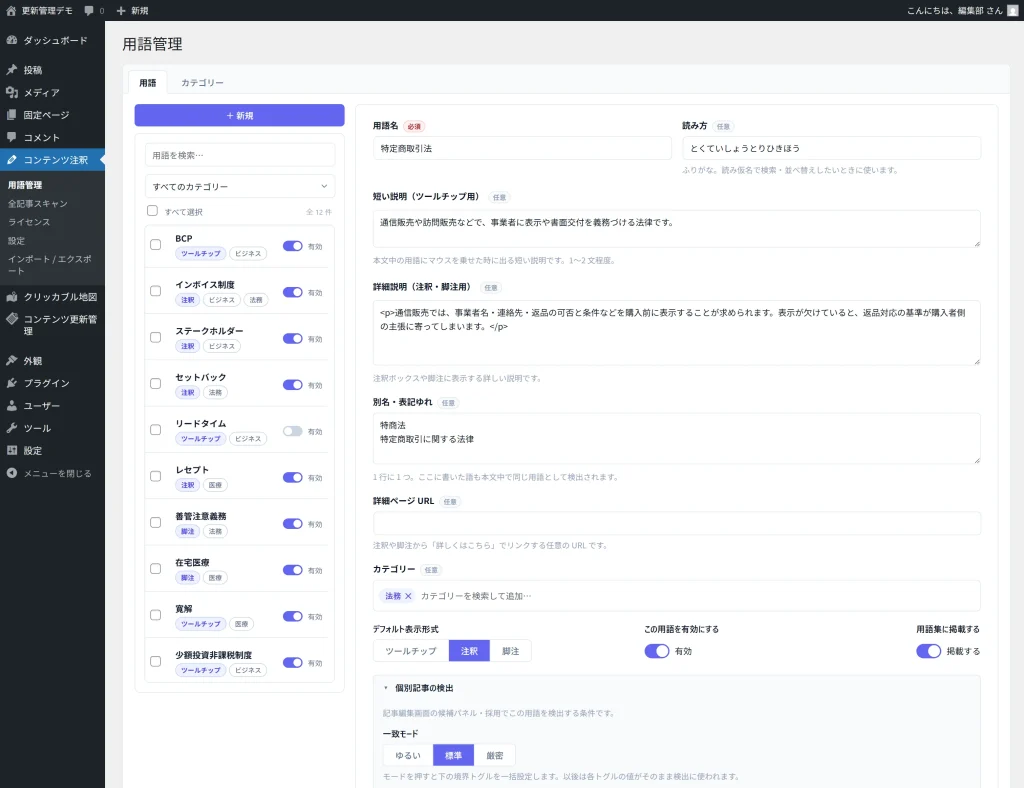
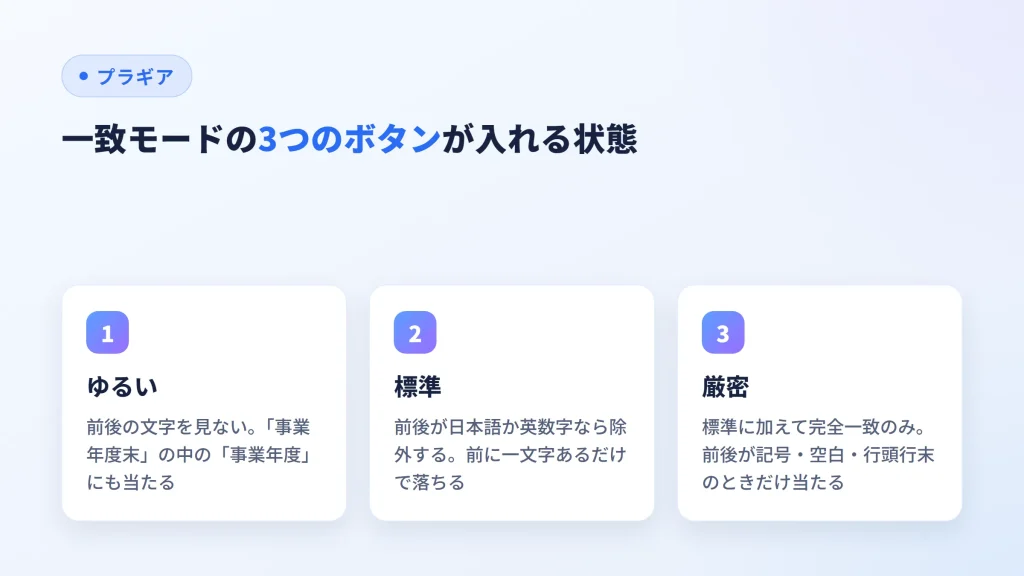
一致モードのボタンを押すと、その下に並んでいる境界判定のトグルがまとめて切り替わります。押したあとに検出を動かしているのは、モードの名前ではなく個々のトグルの値です。だからトグルを1つ手で戻せば、その用語はもうモード名どおりには動かない。
3つのボタンが入れる状態は、次のとおりです。
| モード | 押すと入る状態 | 本文でどう効くか |
|---|---|---|
| ゆるい | 前後の文字を見ない | 「事業年度末」の中の「事業年度」にも当たる |
| 標準 | 前後が日本語なら除外/前後が英数字なら除外 | 前後に日本語や英数字が続いていると当たらない |
| 厳密 | 標準に加えて「完全一致のみ」 | 前後がともに記号・空白・括弧・行頭行末のときだけ当たる |
「後ろが助詞なら除外しない(を/が/は/に…)」は、この3つのボタンでは動きません。独立したトグルで、既定はオフ。次の節がそのまま効いてきます。
標準のままだと、前に一文字あるだけで落ちる
標準に入っているのは「前後が日本語なら除外」です。見ているのは一致した文字のすぐ隣1文字だけ。本文に「対象は特定商取引法です」と書いてあれば、直前の「は」が日本語なので、この一致は落ちます。「改正特定商取引法」のように前へ漢字が続く場合も同じ。
標準のまま拾えるのは、用語の直前が記号・空白・句読点・括弧、あるいは段落の書き出しに来ているときです。「。特定商取引法は……」なら直前が句点なので通る。日本語の地の文でその条件が揃う頻度を考えると、初回のドライランで候補が想像よりずっと少なく出る理由はここにあります。
直後にも同じ判定がかかりますが、こちら側には抜け道が用意されています。「後ろが助詞なら除外しない」をオンにすると、直後が を・が・は・に・へ・と・の・で・も・や・から・まで・とは・について のいずれかで始まるときだけ、日本語が続いていても切り出す。形態素解析はしていません。一致位置の直後を数文字だけ先読みして、この並びで始まるかを見るだけです。だから「特定商取引法違反」の「違」では免除されず、複合語の途中に食い込むこともない。
免除があるのは直後だけで、直前側にはありません。前に文字が続く一致まで拾いたいならゆるい側へ倒すしかなく、そのときは複合語の内側に当たるのを引き受けることになります。
このサイト(plugear.net)の辞書は、日本語の用語をすべてゆるいにしています。地の文では用語の直前に助詞や漢字が来るのが普通で、標準では上に書いたとおりそこがそのまま落ちるからです。英字の略語だけは逆に締めて、英数字境界のみ・大文字小文字を区別に。コードや拡張子に混じる小文字の json を拾わないための線引きです。「JSON」と「JSON-LD」のように前方が重なる語は両方登録して、最長一致に任せています。
厳密は、日本語の本文ではほとんど当たらない
厳密が入れるのは「完全一致のみ」です。判定は単純で、一致の前後がどちらも記号・空白・句読点・括弧、または行頭行末でなければ当てない。助詞の免除も、この状態では効きません。
日本語の文章にこれを当てると、当たるのは括弧で囲まれた語、句読点に挟まれた語、行の先頭くらい。英字の用語がスペースに挟まれている箇所なら素直に効きますが、地の文には向きません。「厳密=安全」と読んで最初にここを選ぶと、候補がほとんど出ないまま設定を疑い直すことになります。
誤爆を抑えたいだけなら、厳密まで行く前に標準で止めておく。そのうえで、暴れている語だけ優先度を下げるか、別名から一般語に近い表記を1行外すほうが早い。1語の事故に辞書全体の判定を巻き込む必要はありません。
モードでは動かないもの
一致モードが触るのは語の切れ目の判定だけです。次の条件は別レイヤーにあるので、モードをどちらへ倒しても変わりません。
最長一致は常に効いていて、辞書は用語の長い順に照合されます。「投資」と「投資信託」を両方登録しても、本文の「投資信託」には長いほうが当たる。同じ用語を各記事の初回だけに付けるかは別のトグルで、既定は初回のみ。2文字以下の用語が既定で検出から外れる最小文字数も、リンク内・ボタン内・コード内・見出し内が対象外なのも、用語ごとの優先度(-100〜100)も、すべてモードとは無関係です。
検出そのものはAIではありません。辞書の用語名と別名(表記ゆれ)を本文の文字列と照合するだけの純ロジックで、DOMのテキストノードだけを走査します。読み方(ふりがな)は照合に使わない。あれは用語集の並べ替えと検索のための項目です。ロジックで動いている以上、同じ辞書に同じ本文をあてれば結果は毎回同じ。トグルを1つ動かして再スキャンすれば、増えた分・減った分がそのまま原因になります。日本語に語の区切り記号が無いなかで、こうした境界のルールを積んで切れ目を作るしかない事情は海外製の用語プラグインが日本語で誤爆する理由のほうに書きました。
一括だけ厳しくして、個別記事はゆるく持つ
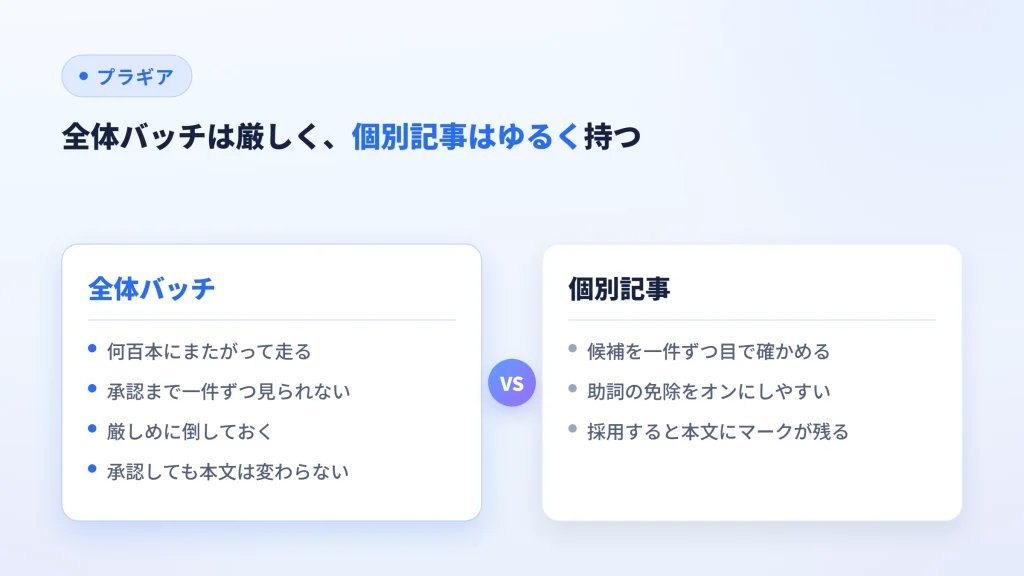
条件が「個別記事の検出」と「全体バッチの検出」に分かれているのは、人の目の入り方が違うからです。全記事スキャンは何百本にまたがるうえ、承認するまで一件ずつは見られない。ここは厳しめに倒しておくのが無難です。対して個別記事のサイドバーに出る候補は、前後の文脈を見ながら一件ずつ採用する使い方なので、助詞の免除をオンにしておいても事故になりにくい。
ただし、ゆるく持つ側には代償があります。個別記事で採用した注釈は、本文にマークが残る。本文を書き換えないのは全記事スキャンの承認のほうです。気軽に採用していく運用を選ぶなら、本文に印が入る前提で。
候補が少ないときに、モードを疑うのは後回し
候補がやけに少ない、あるいは確かに本文へ書いた用語が出てこない。このとき最初に一致モードへ手が伸びますが、原因が別のところにあることも多い。用語そのものが無効になっている、拾わせたい表記を別名ではなく読み方の欄に入れている、2文字以下で最小文字数に届いていない、その語が見出しやリンクの中にしか出てこない。どれもモードでは直りません。別名と読み方の役割分担は用語辞書の作り方で整理してあるので、心当たりがあれば先に潰しておく。
そこまで潰したうえで残るのが、この記事で見てきた助詞と境界の話です。トグルを動かしたら承認せずにドライランを回し、候補テーブルの「検出文字」と「前後文脈」を読む。承認して反映した分を取り消せるのは直前の1回だけなので、往復はドライランの中で済ませます。対象の絞り込みや除外設定と合わせた下ごしらえの全体像は全記事一括注釈の下準備にまとめてあります。
決めるのは登録するとき、あとは辞書の性格が変わったときだけ
一致モードは、日々ダイヤルを回して詰めるたぐいの設定ではありません。用語を登録する時点で一度決め、その後に触るのは辞書の性格が変わったときだけ。英字略語をまとめて足した、一般語に近い語を追加した、といったタイミングです。
開発していて最後まで迷ったのが、この既定値の向きでした。結論として、保守的な側へ倒してあります。2文字以下は対象外、前後の文字はどちらも見る、助詞の免除は明示的にオンにする、見出しは除外、自動反映はしない。緩い初期値で全記事に注釈が撒かれてから戻すより、静かすぎる状態から一段ずつ緩めるほうが、取り返しがつくからです。最初のドライランで候補が思ったより少なくても、それは設計どおりの静けさだと思ってください。
各条件がどこに並んでいるかは、用語を1件開いて検出のセクションを展開するのがいちばん早いはずです。設定項目の全体像は用語注釈マネージャーの製品ページに置いてあります。